HR im KI-Tempo · Ausgabe 002 ·
Sicher heißt nicht richtig: Wo die KI im Recruiting an ihre Grenze kommt
Wie weit du der KI bei der Eignung trauen kannst – technisch erklärt.
Ein Dirigent und ein Verkehrspolizist heben beide die Hand, und Dutzende Menschen richten sich danach. Dass der Verkehrspolizist deshalb noch lange kein Orchester leiten kann, siehst du sofort, und du verstehst sogar, warum jemand die beiden verwechseln könnte. Bei einem Sprachmodell wie ChatGPT ist beides nicht sicher: Es kann den Fehlschluss machen, und der Grund dafür kann etwas sein, auf das du nie kommen würdest. Ein Sprachmodell arbeitet wie ein „Alien-Gehirn“: in sich logisch, aber nicht wie wir. Darum geht es heute, und um eine zweite Grenze, die auch ein besseres Modell nicht überwindet.
Vorweg, was gut funktioniert: Den Satz „hat Rahmenverträge mit Lieferanten verhandelt“ ordnet ein Sprachmodell nach meiner Erfahrung zuverlässig der Anforderung „Verhandlungserfahrung“ zu. Wie weit du ihm darüber hinaus trauen kannst, hängt davon ab, wie es entscheidet, und deshalb wird diese Ausgabe etwas technischer. Danach weißt du, wofür die KI heute ein verlässlicher Sparringspartner ist, wo ihre Grenzen liegen, warum wir Menschen ihrem Urteil zu schnell folgen und wo der Hype aufhört.
Das Wichtigste
- Wir stehen erst am Anfang zu verstehen, wie ein Sprachmodell entscheidet. Einen sehr guten Grundstein sehe ich in einer Arbeit von Goodfire vom Oktober 2026, bis Ende 2027 erwarte ich große Fortschritte. Heute ist es aus meiner Sicht noch zu früh, dem Urteil eines Sprachmodells über die Eignung zu trauen.
- Zuordnen: ja. Ein Sprachmodell kann dir verlässlich zeigen, welcher Satz einer Bewerbung welche Anforderung belegt.
- Empfehlen: auch, aber nur mit Belegen. Am Beleg siehst du, ob du die Einschätzung teilst. Dem Urteil allein solltest du nicht trauen, aus zwei Gründen:
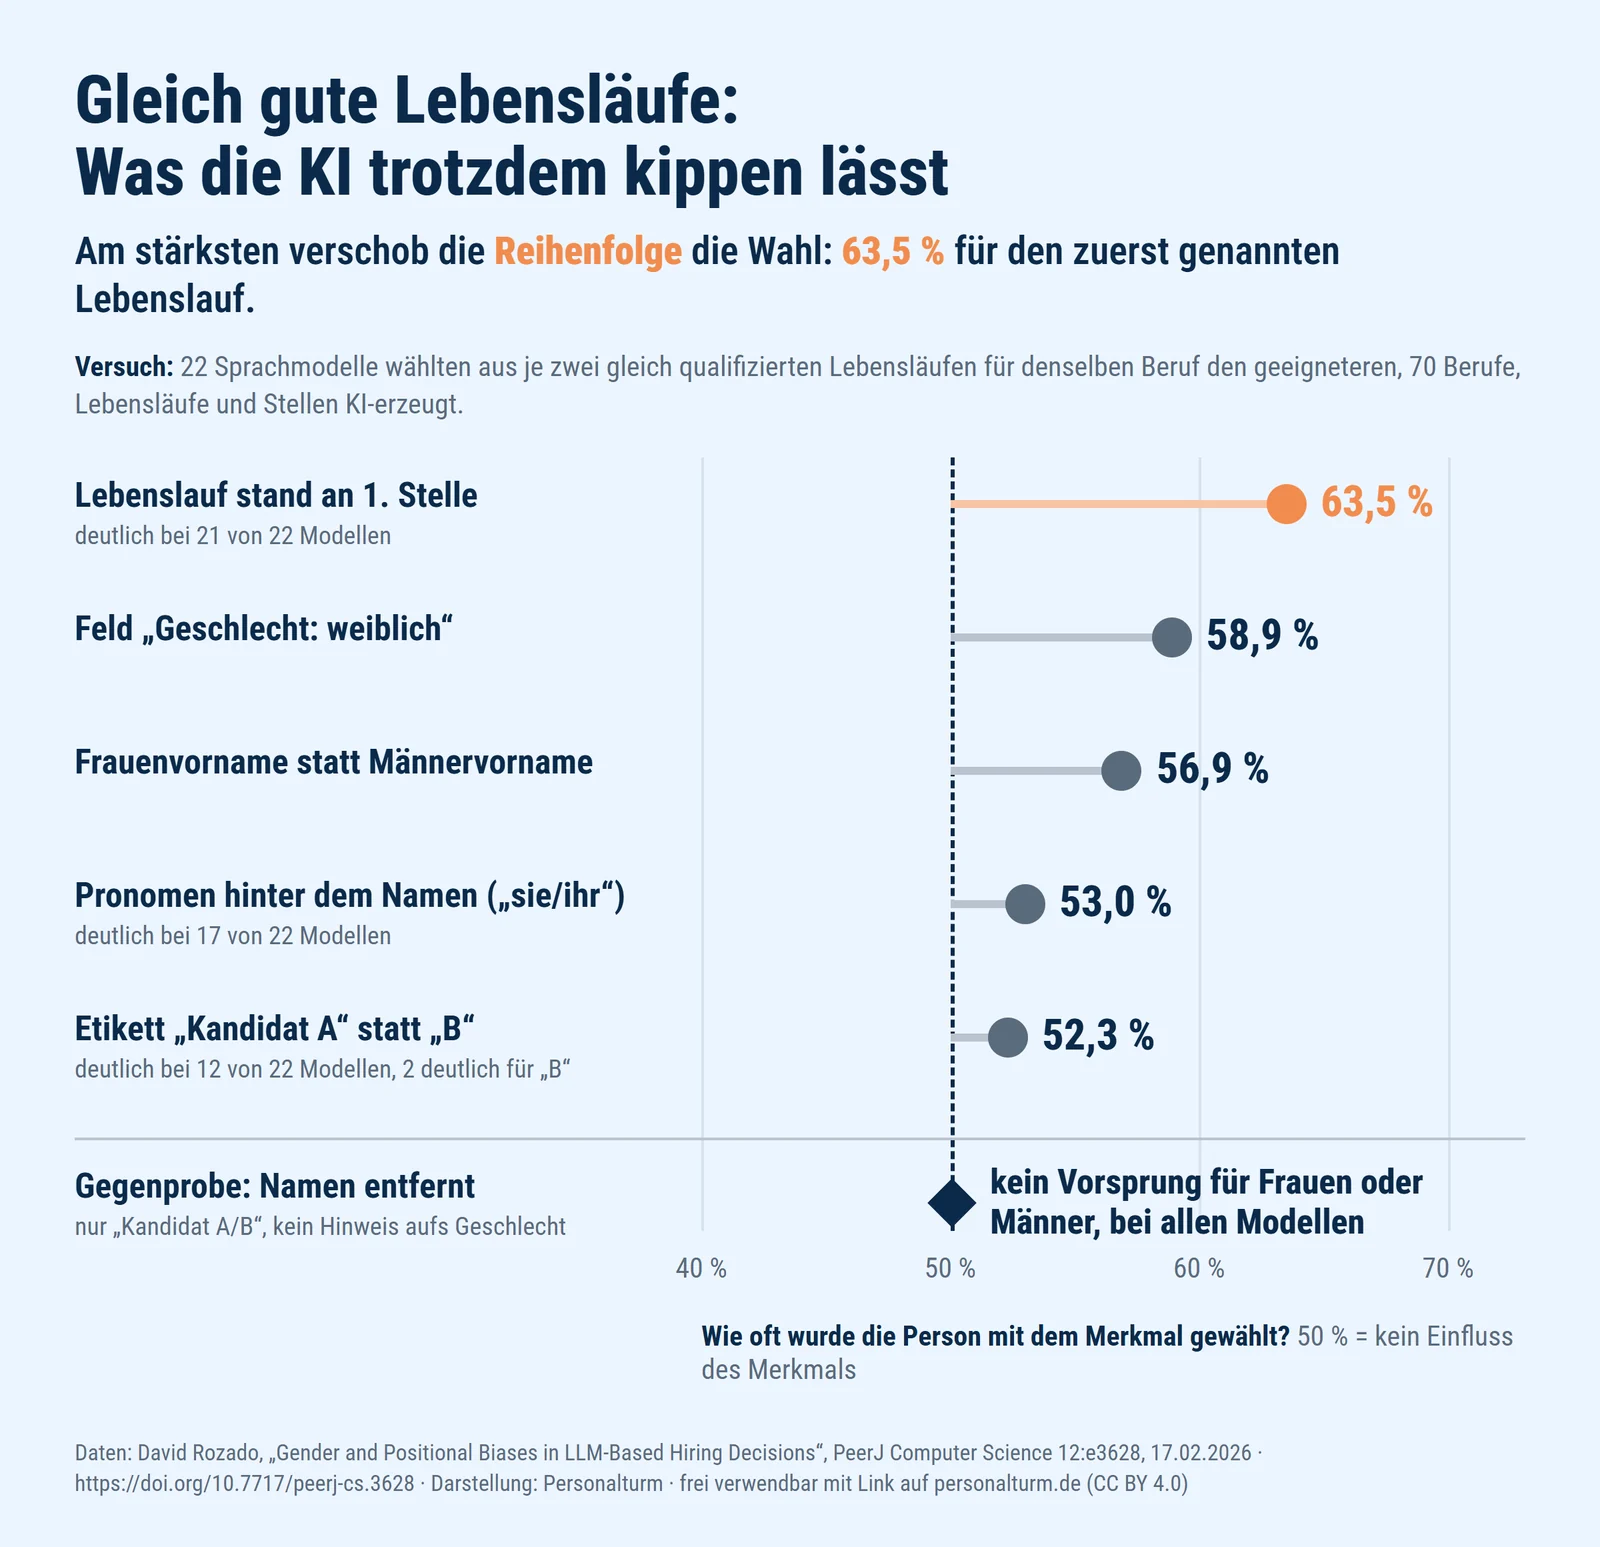
- Grund 1: Das Modell achtet womöglich auf das Falsche und klingt dabei sicher. Von zwei Lebensläufen für denselben Beruf wählten Sprachmodelle in einem Test in 63,5 % der Fälle den zuerst genannten (Rozado, 2026).
- Und wir folgen ihm: In einem Experiment bevorzugten Menschen mit einer voreingenommenen KI in bis zu 90 % der Fälle dieselbe Gruppe wie die KI (Wilson, Caliskan u. a., 2025). Dessen solltest du dir bewusst sein.
- Grund 2: Die Antwort steht oft nicht in den Unterlagen. Ob ein Konzern-Einkäufer auch im Mittelstand gut verhandelt, zeigt kein Lebenslauf.
- Konsequenz: Frage bei jedem „passt“: Welcher Satz belegt das?
Innenleben: Selbst die Hersteller verstehen ihre Modelle erst in Ansätzen
Ein Sprachmodell wird nicht Regel für Regel programmiert, sondern mit großen Datenmengen trainiert. Deshalb verstehe man nicht, wie die Modelle das meiste von dem tun, was sie tun, schrieb Anthropic im März 2025. Firmenchef Dario Amodei nennt solche Systeme mit einem Satz seines Mitgründers Chris Olah eher gewachsen als gebaut. Vereinfacht gesagt: Man gibt dem Modell Rechenleistung, Daten und ein Lernverfahren, und wie es Aufgaben löst, bringt es sich beim Training selbst bei. Wir wissen also, wie man ein Modell leistungsfähiger macht, aber nicht im Detail, wie diese Leistung entsteht und wie sein „Denken“ von innen aussieht.
Inzwischen versucht die Forschung, die Modelle von innen zu entschlüsseln, Neuron für Neuron. Ein Neuron ist eine einzelne Recheneinheit im Modell. Bei Bildmodellen ist das schon weit: Laut Nick Cammarata vom Forschungsunternehmen Goodfire (Oktober 2026) lassen sich in der letzten Verarbeitungsstufe eines überarbeiteten Bilderkennungsmodells 99–100 % der Neuronen leicht verstehen. Für mich ist das eine der besten Nachrichten der letzten Jahre: Bisher blieb das Innere der Modelle weitgehend undurchschaubar. Jetzt fangen wir an zu verstehen, wie ein Modell von innen denkt. Noch stehen wir dabei aber am Anfang: Bei Sprachmodellen gibt es erst vorläufige Prüfungen, und Cammarata nennt das Ganze selbst eine Arbeitshypothese.
Meine Einordnung, als Bild: Ein Sprachmodell ist für mich wie ein „Alien-Gehirn“. Wir wissen, wie man es trainiert, und fangen gerade erst an zu entschlüsseln, was es dabei gelernt hat.
Grund 1: Das Modell achtet womöglich auf das Falsche und klingt dabei sicher
Das V statt der Katze
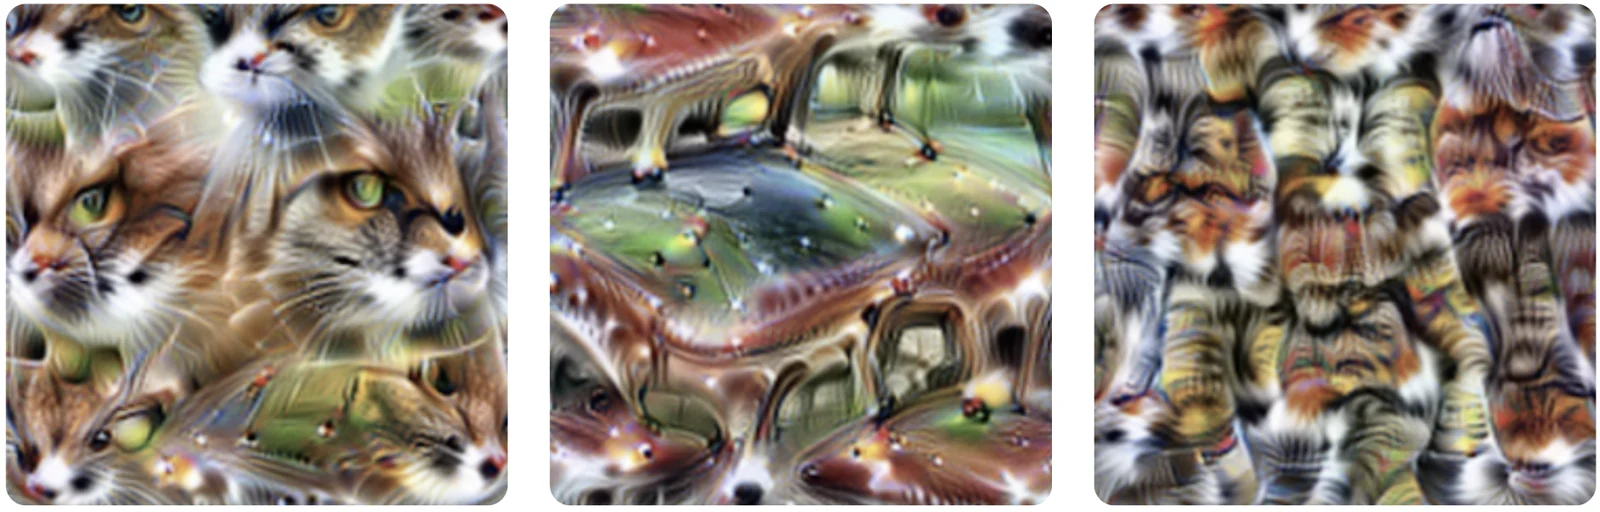
Wie fremd diese Logik sein kann, zeigt ein Neuron aus einem älteren Bildmodell von 2014, das auf Katzengesichter und Autofronten ansprang. Laut Cammarata ist es aber kein Katzen-und-Auto-Neuron, sondern ein V-Form-Neuron: Katzengesicht und Autofront haben eine spitz zulaufende V-Form gemeinsam. Runde Formen bremsen es dagegen.
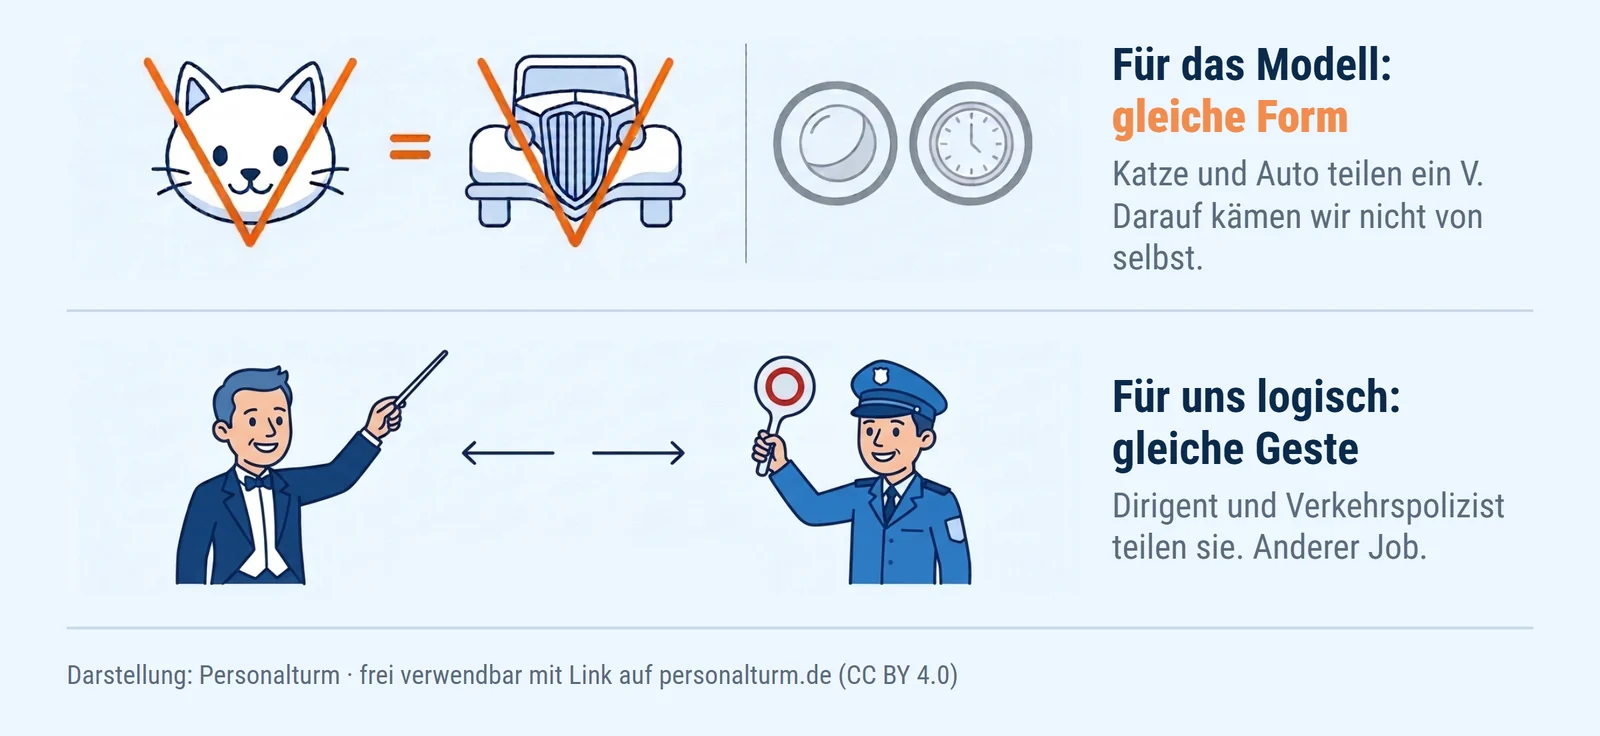
Meine Einordnung: Das eigentlich Verblüffende ist, dass hinter der V-Form durchaus eine Logik steckt, nur keine, die wir von selbst erkennen. Dass die erhobene Hand aus einem Verkehrspolizisten keinen Dirigenten macht, verstehen wir sofort. Auf das V als Gemeinsamkeit von Katze und Auto käme dagegen kein Mensch. Lädt jemand einen Lebenslauf hoch, weiß heute niemand, welche Neuronen dabei anspringen. Vielleicht reagiert das Modell auf das Wort „Vertrieb“ und erkennt richtig, dass es um diese Tätigkeit geht. Das heißt aber nicht, dass es den Unterschied mitdenkt: kurze oder lange Verkaufszyklen, investitionsintensive B2B-Anlagen oder günstige Wegwerfprodukte für Endkunden. Oder es reagiert auf etwas ganz anderes. Ein ausgedachtes Gedankenspiel: Auf vielen Verpackungen steht im Kleingedruckten „Vertrieb: XY GmbH“, und solche Angaben können über Produkttexte im Netz in die Trainingsdaten gelangen. Ein Neuron könnte „Vertrieb“ deshalb eng mit Verpackungen verknüpfen. Hat jemand dann in der Verpackungsbranche gearbeitet, wirkt seine Vertriebserfahrung für das Modell größer, als sie ist, und niemand sieht, warum. Genau das meine ich mit „Alien-Gehirn“.
Und genau hier liegt das Problem: Das Modell begründet sein Urteil schlüssig und trägt es selbstsicher vor. Ich vermute, das liegt daran, dass es in seiner eigenen Denkwirklichkeit Sinn ergibt. Und wir Menschen lassen uns davon überzeugen.
Begründung und Selbstsicherheit: Sicher heißt nicht richtig
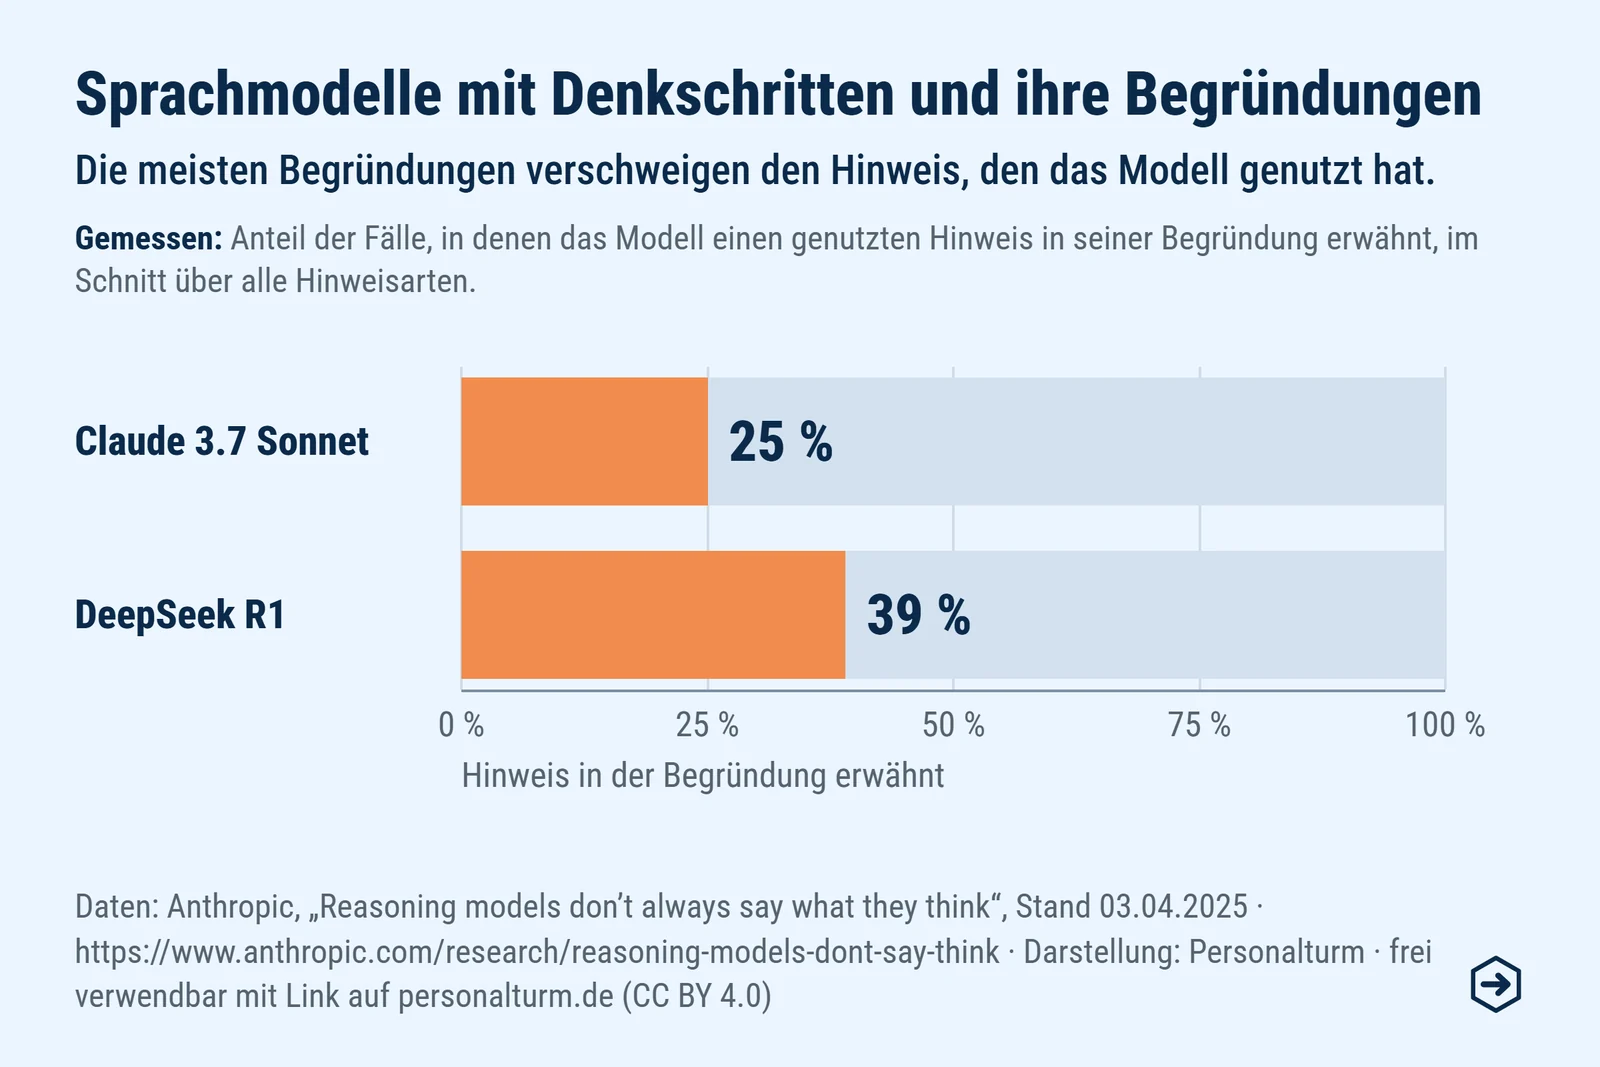
Ob ein Modell auf ein V reagiert hat, müsste seine Begründung verraten. Anthropic hat das im April 2025 getestet und den Modellen bei Testfragen einen Hinweis auf eine Antwort mitgegeben, mal richtig, mal absichtlich falsch, wie einen Spickzettel. Nutzte Claude 3.7 Sonnet den Hinweis, erwähnte es ihn in seiner Begründung im Schnitt nur in 25 % der Fälle, DeepSeek R1 in 39 %. Im Bild gesprochen: Wer schummelt, liefert eine Begründung, die gut klingt.
Ob eine Antwort stimmt, verrät auch die Selbstsicherheit des Modells nicht, wie ein Test der Carnegie Mellon University zeigt (Juli 2025, ältere Modellversionen). Gemini sollte 20 Skizzen erraten, ähnlich wie beim Spiel Montagsmaler, und traute sich vorab im Schnitt 10,03 Treffer zu. Hinterher glaubte es, 14,40 geschafft zu haben, tatsächlich waren es 0,93.
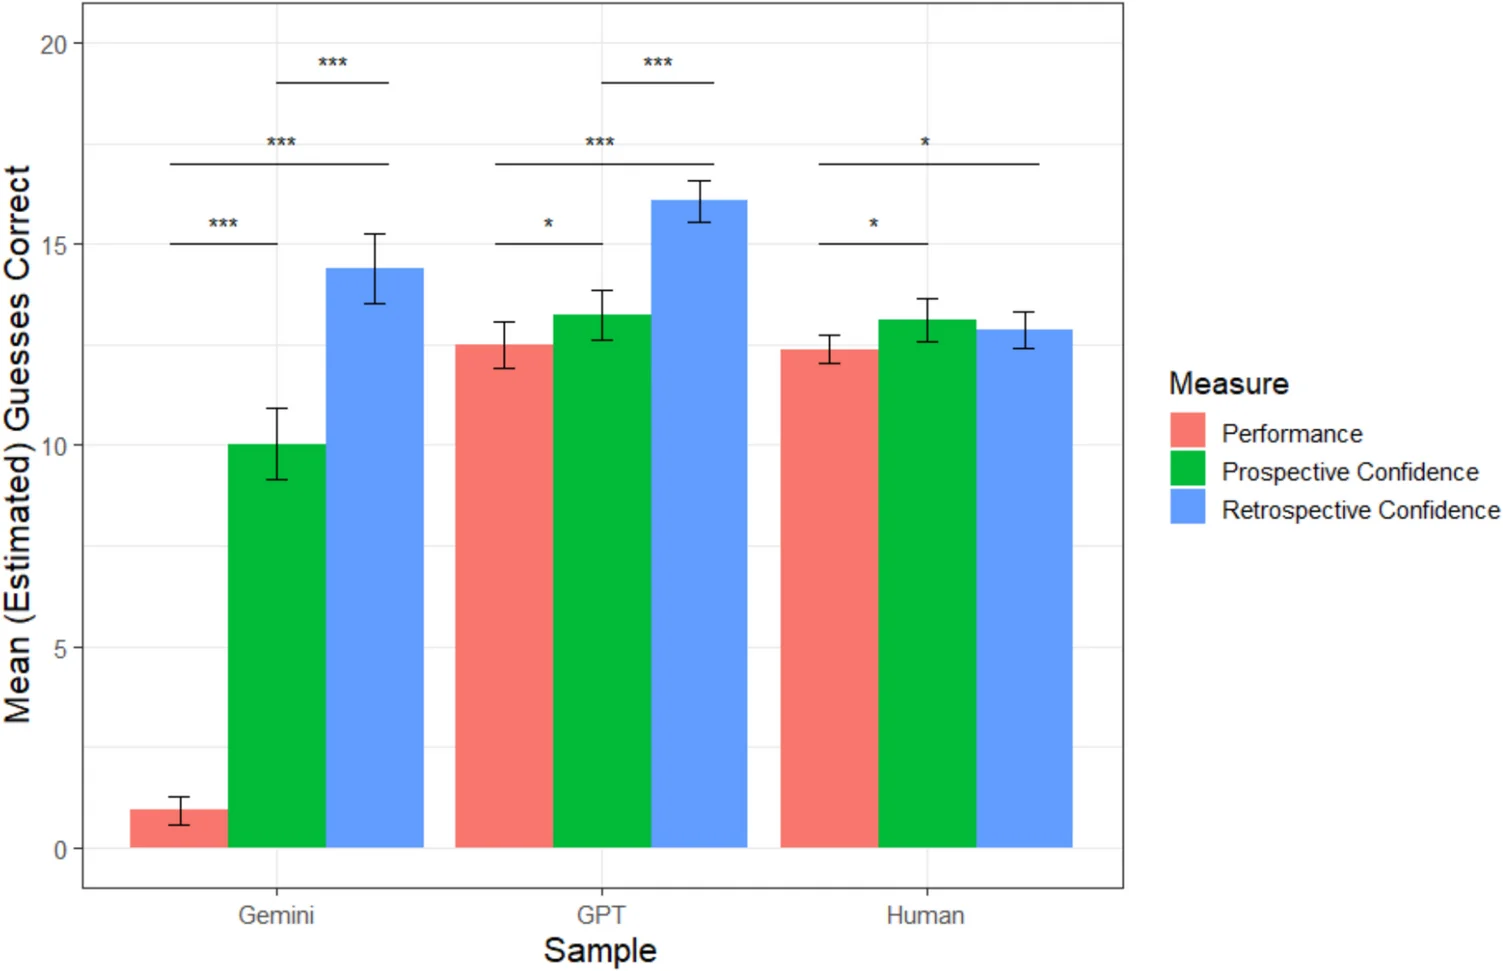
Was das für dich heißt: Weder die Begründung noch die Selbstsicherheit des Modells zeigt dir, worauf sein Urteil beruht.
Der Mensch: Die Empfehlung der KI zieht uns mit
Wie stark uns eine KI-Empfehlung mitzieht, zeigt ein Experiment von Wilson, Caliskan u. a. (Oktober 2025): 528 Teilnehmende sichteten Lebensläufe zusammen mit einer simulierten KI, deren Vorlieben die Forscher festgelegt hatten. Ohne KI wählten die Teilnehmenden Bewerbende unterschiedlicher ethnischer Herkunft gleich oft. Bevorzugte die KI eine Gruppe, bevorzugten sie dieselben Bewerbenden in bis zu 90 % der Fälle.
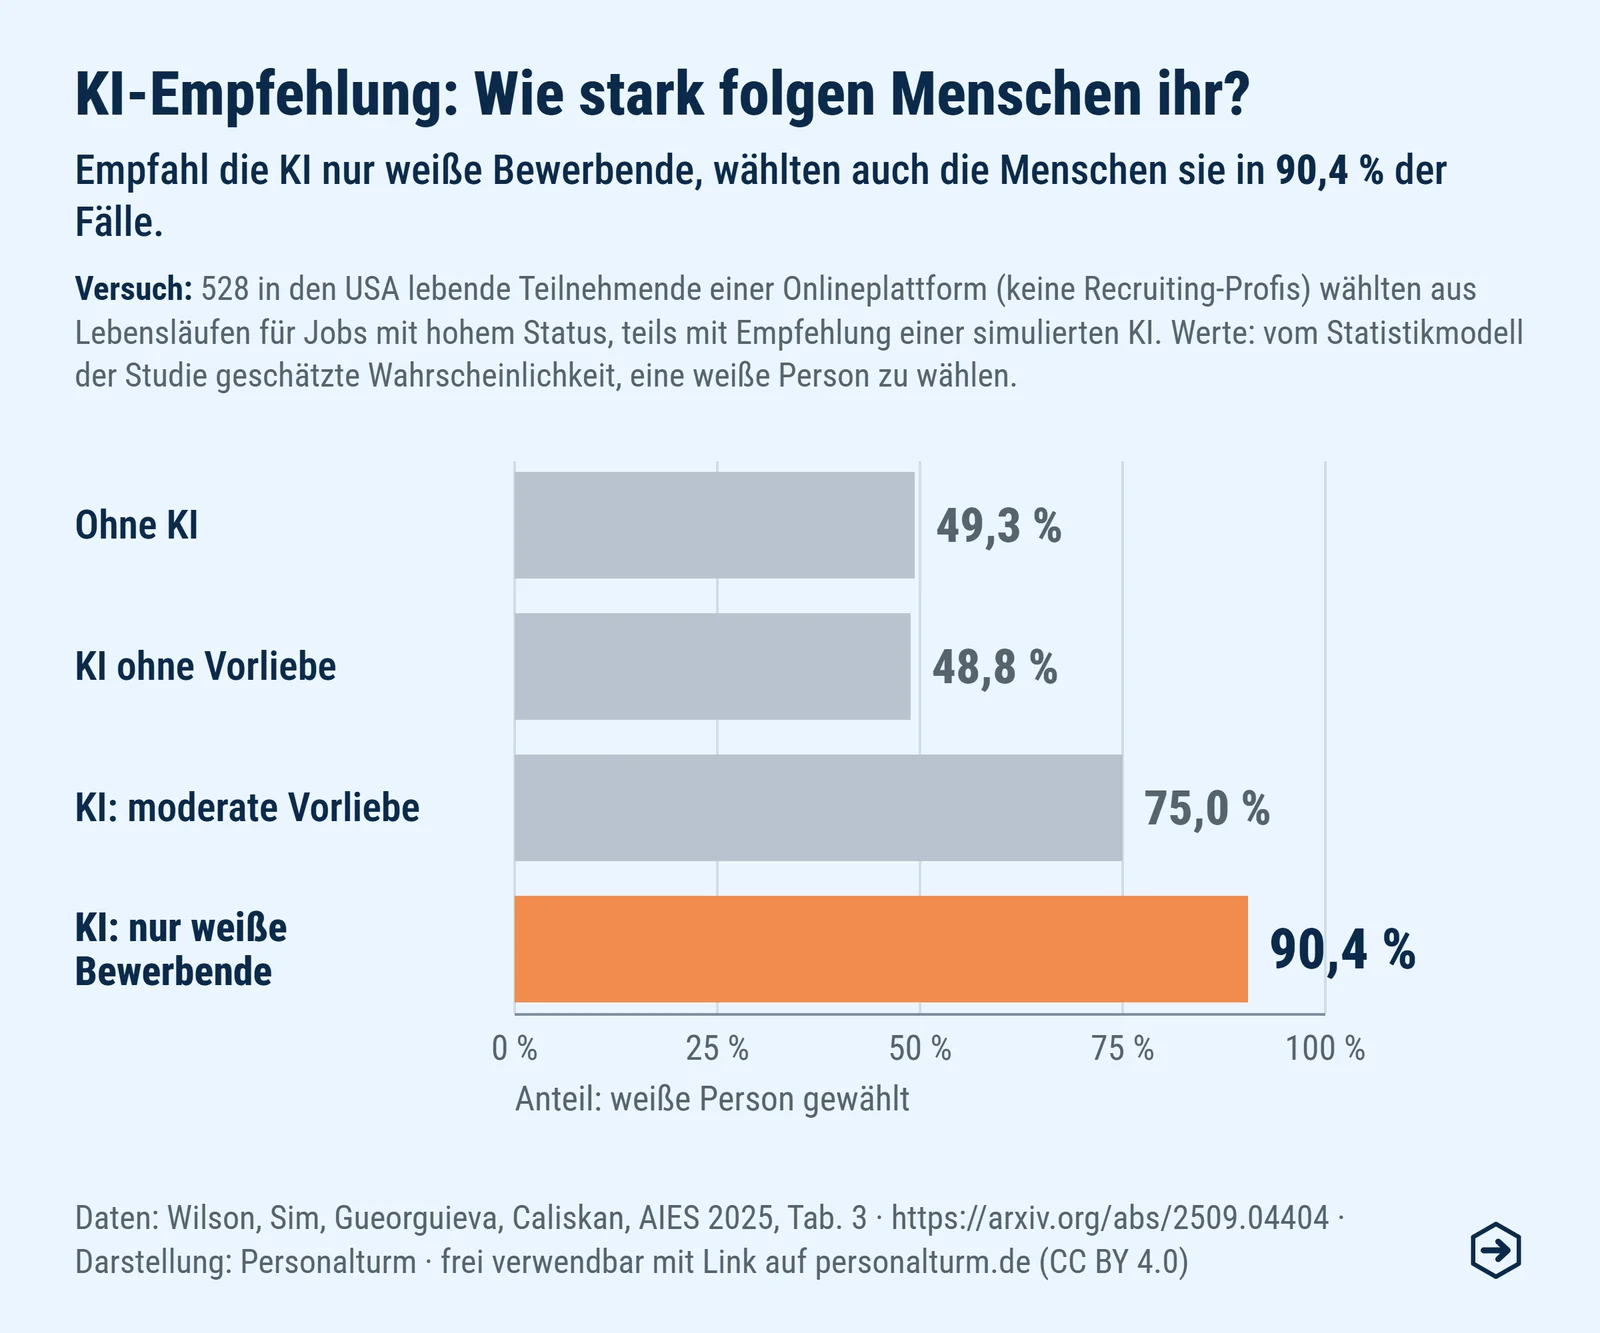
Ein ähnliches Muster zeigte sich bei Profis: In einer Studie mit 1.208 Recruiting-Fachleuten (Lacroux und Martin Lacroux, International Journal of Selection and Assessment, Oktober 2026) vertrauten sie einem KI-System weniger als dem Rat eines menschlichen Experten, ließen sich aber stärker vom KI-System beeinflussen.
Was das für dich heißt: Die KI zieht uns stark zu ihrer Empfehlung hin, dessen solltest du dir bei jedem Vorschlag bewusst sein. Korrigieren kannst du sie nur, wenn du siehst, worauf ihr Urteil beruht.
Im Recruiting: Reihenfolge und Geschlecht entscheiden mit
Worauf ein Modell im Recruiting anspringen kann, zeigt David Rozado (PeerJ Computer Science, Februar 2026). Er ließ 22 Sprachmodelle für Stellen aus 70 Berufen jeweils zwischen zwei Lebensläufen für denselben Beruf wählen, einer mit Frauen-, einer mit Männervornamen. Die Modelle wählten in 63,5 % der Fälle den zuerst genannten Lebenslauf und in 36,5 % den zweiten. Standen eine Bewerberin und ein Bewerber zur Wahl, fiel die Wahl in 56,9 % der Fälle auf die Bewerberin. Jobfremde Merkmale entscheiden also messbar mit.
Ähnlich wie für das V fand Anthropic 2024 auch für das Thema Geschlecht und Beruf ein eigenes Merkmal im Modell, in einem Forschungsversuch mit Claude 3 Sonnet: Ohne Eingriff beschrieb das Modell eine Pflegekraft mal als Frau, mal als Mann; verstärkten die Forscher das Merkmal künstlich, überwiegend als Frau.
Was das für dich heißt: Empfiehlt dir ein Modell Frau A, willst du nicht raten müssen, ob seine Begründung nur schlüssig wirkt, ob es sie wirklich für passender hält als Herrn B oder ob ihr Lebenslauf schlicht oben auf dem Stapel lag.
Gegenstimme: Neuere Modelle verzerren anders, frei davon sind sie nicht
Sind neuere Modelle schon weiter? Bei der Herkunft zum Teil: Gao, Jiang und Yan untersuchten 14 Sprachmodelle mit US-Stellenanzeigen (Juni 2026, noch nicht begutachtet). Nur das älteste, ein Modell von 2023, bevorzugte weiße Bewerbende, um 2,12 Prozentpunkte. Bei den Modellen ab 2024 verschwand dieser Vorteil, einige bevorzugten nun schwarze Bewerbende, um bis zu 3,01 Prozentpunkte.
Meine Einordnung: Die alte Verzerrung haben die Hersteller offenbar angegangen, frei von Bias sind auch neuere Modelle nicht. Die Reihenfolge misst die Studie nicht, die kannst du selbst prüfen (zweiter Schritt unten).
Grund 2: Die entscheidende Antwort fehlt oft in den Unterlagen
Selbst ein Modell, das auf das Richtige achtet, stößt an eine zweite Grenze: Ob jemand auch das kann, was du suchst, steht oft gar nicht in den Unterlagen. Nimm das Beispiel vom Anfang. Ein Einkäufer hat im Konzern jahrelang Rahmenverträge verhandelt und bewirbt sich bei einem Betrieb mit 80 Beschäftigten (ausgedachtes Beispiel). Seine Verhandlungserfahrung belegt der Lebenslauf, ob er im Mittelstand genauso gut verhandelt, lässt sich daraus nicht ablesen.
Meine Einordnung: Im Konzern sitzt bei jeder Verhandlung ein großes Bestellvolumen mit am Tisch. Im Mittelstand fehlt dieser Hebel, dort zählen die Beziehung zum Lieferanten und Überzeugungskraft ohne Druckmittel. Gut möglich, dass ihm beides liegt. Klären kann das erst das Gespräch, etwa mit der Frage, wie er einen Lieferanten ohne Mengenvorteil zu einem besseren Preis bewegt hat.
Personalturm: Erst saubere Daten, dann Bewertung
Für unsere KI-gesteuerte Recruiting-Software ziehen wir daraus eine klare Konsequenz: Die Entscheidung über eine Person bleibt bei dir.
Unser Schwerpunkt liegt deshalb heute auf einer sauberen Aufbereitung der Daten, damit das Sprachmodell eine möglichst neutrale Entscheidungsgrundlage bekommt. Ganz ausschließen lässt sich Bias damit heute nicht.
Ich rechne damit, dass sich ab 2027 sehen lässt, was in einem Modell bei einer Bewertung passiert. Dann soll die KI auf dieser sauberen Grundlage deutlich neutraler bewerten können.
Ausblick: Die erste Grenze kann sich verschieben, die zweite bleibt
Bleibt es bei diesen Grenzen? Macht das Entschlüsseln auch bei Sprachmodellen die erwarteten Fortschritte, kann sich die Grenze aus Grund 1 verschieben. Grund 2 bleibt, denn was in keinem Lebenslauf steht, findet auch ein entschlüsseltes Modell nicht.
Heute liegen Erwartung und Ergebnis noch weit auseinander: In einer Befragung von ManpowerGroup unter 80 Führungskräften aus Geschäftsleitung, Personal und Recruiting in den USA und Großbritannien (Auftragsstudie, Juni 2026) setzen mehr als 90 % der Organisationen KI in der Personalgewinnung ein, weniger als 5 % berichten von grundlegend veränderten Ergebnissen.
Meine Einordnung: Diese Lücke wundert mich nicht. Ein Sprachmodell kann in seinem „Alien-Gehirn“ Zusammenhänge herstellen, die dort folgerichtig sind, in unserer Welt aber nicht tragen. Je komplexer die Aufgabe und je weniger offensichtlich die Zusammenhänge, desto größer ist die Gefahr, dass es schlicht danebenliegt, und die Auswahl von Menschen ist eine sehr komplexe Aufgabe. Der Hype hört für mich dort auf, wo ein Werkzeug dir ein „passt“ liefert, ohne zu zeigen, worauf es beruht. Nach Grund 1 und Grund 2 kann heute kein Sprachmodell ein solches Gesamturteil verlässlich fällen, und nach Wilson folgen wir ihm trotzdem.
All das gilt für die Personalauswahl. Im Personalmarketing gelten andere Regeln: welche Werbemittel und Botschaften du einsetzt, wie du eine Anzeige textest und welche Daten du dafür heranziehst.
Was du tust: drei Schritte
Erstens: Frage bei jedem „passt“, welcher Satz das belegt. Ohne Satz fehlt der Beleg, mit Satz prüfst du ihn selbst.
Zweitens: Prüfe Reihenfolge und Namen. Wenn du ChatGPT schon nutzt, um Bewerbungen zu vergleichen, gib sie ein zweites Mal in umgekehrter Reihenfolge ein und vertausche dabei Merkmale wie Namen und Geschlecht. Ändert sich das Ergebnis, vergleiche die Bewerbungen selbst, Anforderung für Anforderung. Bleibt es gleich, ist die Wahl damit noch nicht richtig. Bei Namen und Geschlecht hilft es, wenn das Modell solche Merkmale gar nicht erst zu sehen bekommt.
Drittens: Nimm die offenen Fragen ins Gespräch mit. Notiere schon beim Sichten, was die Unterlagen nicht zeigen.
Woran du merkst, dass es wirkt:
- Für jede Einladung zum Gespräch kannst du die Sätze nennen, auf denen sie beruht.
- Lässt du ChatGPT vergleichen, weißt du, ob Reihenfolge oder Namen das Ergebnis verändert haben.
- Im Gespräch geht es vor allem um das, was die Unterlagen offenlassen.
Fazit: Die KI liefert den Beleg, den Schluss ziehst du
Dass jemand viele Menschen gleichzeitig gelenkt hat, kann dir ein Sprachmodell heraussuchen und mit einem Satz belegen. Bei dieser Zuordnung ist die KI ein verlässlicher Sparringspartner, weil du ihr Ergebnis in deiner eigenen Logik prüfen kannst. Auch eine Empfehlung kann sie dir geben, solange sie die Belege mitliefert. Nur trauen solltest du ihrem Urteil heute noch nicht, und am wenigsten dann, wenn es dich überzeugt, ohne dass du siehst, worauf es beruht. Ob ein Dirigent oder ein Verkehrspolizist vor dir sitzt, klärst du im Gespräch und entscheidest du. Gut zusammenarbeiten können wir mit der KI, sobald wir das „Alien-Gehirn“ nicht mehr für ein menschliches halten. Wo hat dir eine KI zuletzt ein „passt“ geliefert, das du nicht nachprüfen konntest? Schreib es mir.
Quellen
Innenleben und Entschlüsseln
- Anthropic, „Tracing the thoughts of a large language model“, 27.03.2025 · https://www.anthropic.com/research/tracing-thoughts-language-model · Unternehmensblog.
- Dario Amodei, „The Urgency of Interpretability“, April 2025 · https://www.darioamodei.com/post/the-urgency-of-interpretability · Essay des Anthropic-Chefs; „grown more than they are built“ schreibt Amodei Chris Olah zu.
- Nick Cammarata (Goodfire), „Neural Networks Are Already Clean“, 15.10.2026 · https://already-clean.goodfire.com/ · laut Autor „working hypothesis“, Prüfungen an Sprachmodellen „preliminary“. 99–100 % gelten für die letzte Schicht eines modernisierten Bildmodells in der Größe von InceptionV1 (2014), bei gleicher Größe und gleichen Trainingsdaten.
- Olah, Cammarata, Schubert, Goh, Petrov, Carter, „Zoom In: An Introduction to Circuits“, Distill, 10.03.2020, CC BY 4.0 · https://distill.pub/2020/circuits/zoom-in/ · Neuron 4e:55 in InceptionV1.
Grund 1: Bewerbungen und Bias
- David Rozado, „Gender and Positional Biases in LLM-Based Hiring Decisions: Evidence from Comparative CV/Résumé Evaluations“, PeerJ Computer Science 12:e3628, 17.02.2026; Preprint arXiv 16.05.2025 · https://peerj.com/articles/cs-3628 · https://arxiv.org/abs/2505.17049 · 22 Sprachmodelle, 70 Berufe, je ein Lebenslauf mit Frauen- und einer mit Männervornamen (Namen in zweitem Durchgang vertauscht); Lebensläufe und Stellen KI-erzeugt; A/B-Etikett: 12 von 22 Modellen bevorzugten „A“, 2 „B“.
- Anthropic (Templeton u. a.), „Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet“, 21.05.2024 · https://transformer-circuits.pub/2024/scaling-monosemanticity/ · Merkmal 34M/24442848 „Gender bias awareness“; das Beispiel entsteht durch künstliches Verstärken (Clamping), nicht im Normalbetrieb.
- Gao, Jiang, Yan, „Can LLMs Hire Fairly? Racial Bias in Resume Screening“, Preprint, 27.06.2026 · https://arxiv.org/abs/2606.28978 · 14 Modelle; GPT-3.5-turbo (2023) +2,12 Prozentpunkte zugunsten weißer Bewerbender, Modelle ab 2024 kein Gap oder ein Gap zugunsten schwarzer Bewerbender (maximal −3,01 Prozentpunkte).
Grund 1: Begründung und Selbstsicherheit
- Anthropic Alignment Science, „Reasoning models don't always say what they think“, 03.04.2025 · https://www.anthropic.com/research/reasoning-models-dont-say-think · Durchschnitt über alle Hinweisarten.
- Carnegie Mellon University, Pressemitteilung 22.07.2025 · https://www.cmu.edu/dietrich/news/news-stories/2025/trent-cash-ai-overconfidence · Paper: Cash, Oppenheimer, Christie, Devgan, „Quantifying uncert-AI-nty“, Memory & Cognition 2025 · https://doi.org/10.3758/s13421-025-01755-4 · vier Sprachmodelle in älteren Versionen.
Grund 1: Kontrolle durch Menschen
- Wilson, Sim, Gueorguieva, Caliskan, „No Thoughts Just AI: Biased LLM Hiring Recommendations Alter Human Decision Making and Limit Human Autonomy“, AIES 2025, 15.10.2025 · https://ojs.aaai.org/index.php/AIES/article/view/36749 · Online-Experiment mit simulierter KI, N=528; 90 % ist ein „bis zu“-Wert.
- Alain Lacroux, Christelle Martin Lacroux, „When Recruiters Meet Algorithms: Advice Taking and Bias in AI-Assisted Recruitment“, International Journal of Selection and Assessment 34, e70085, online 03.10.2026 · https://doi.org/10.1111/ijsa.70085 · Experiment, 1.208 Recruiting-Profis, Rat eines menschlichen Experten vs. algorithmisches System, „trust–reliance paradox“.
Ausblick
- ManpowerGroup Talent Solutions / Everest Group, „The New Talent Equation“, Pressemitteilung 23.06.2026 · https://www.manpowergroup.com/en/news-releases/news/90-of-companies-use-ai-in-hiring-fewer-than-5-are-seeing-it-work · 80 Führungskräfte (C-Suite, CHRO, Talent Acquisition), USA und Großbritannien; „More than 90% of organizations have deployed AI in talent acquisition, yet fewer than 5% report transformational outcomes“; Auftragsstudie, kleine Stichprobe.
Personalturm
- Eigene Angaben: Schwerpunkt Datenaufbereitung; Entscheidung über Personen bleibt beim Menschen.

Gründer und Geschäftsführer von Personalturm, einer KI-gesteuerten Recruiting-Software für Multiposting, Bewerbermanagement und Karriereseite. Seit 2018 im Recruiting aktiv. Schreibt über Stellenanzeigen, Multiposting, Recruiting-Kosten und KI im Recruiting.
Profil und alle Beiträge LinkedIn-Profil

 Kanal abonnieren